Pourquoi mesurer la productivité des développeurs est si difficile ?
Fin mars 2026, Garry Tan, le PDG de Y Combinator, annonce sur X qu'il livre 37 000 lignes de code par jour, sur cinq projets à la fois, grâce à ses agents IA. Deux jours plus tard, un développeur polonais ouvre le capot de son site public. Il y trouve 78 400 lignes de code, une page d'accueil qui charge 6,42 Mo en 169 requêtes, du code superflu et des erreurs de débutant[1].
Cette histoire pose deux questions. La première occupe les directions depuis cinquante ans : comment mesurer la productivité d'un développeur ? La seconde est toute neuve, et je crois qu'elle va devenir centrale : quand une machine écrit le code, faut-il encore qu'un humain le relise ?
Dix mille fois plus de code mais des gains qui se comptent en pour cent
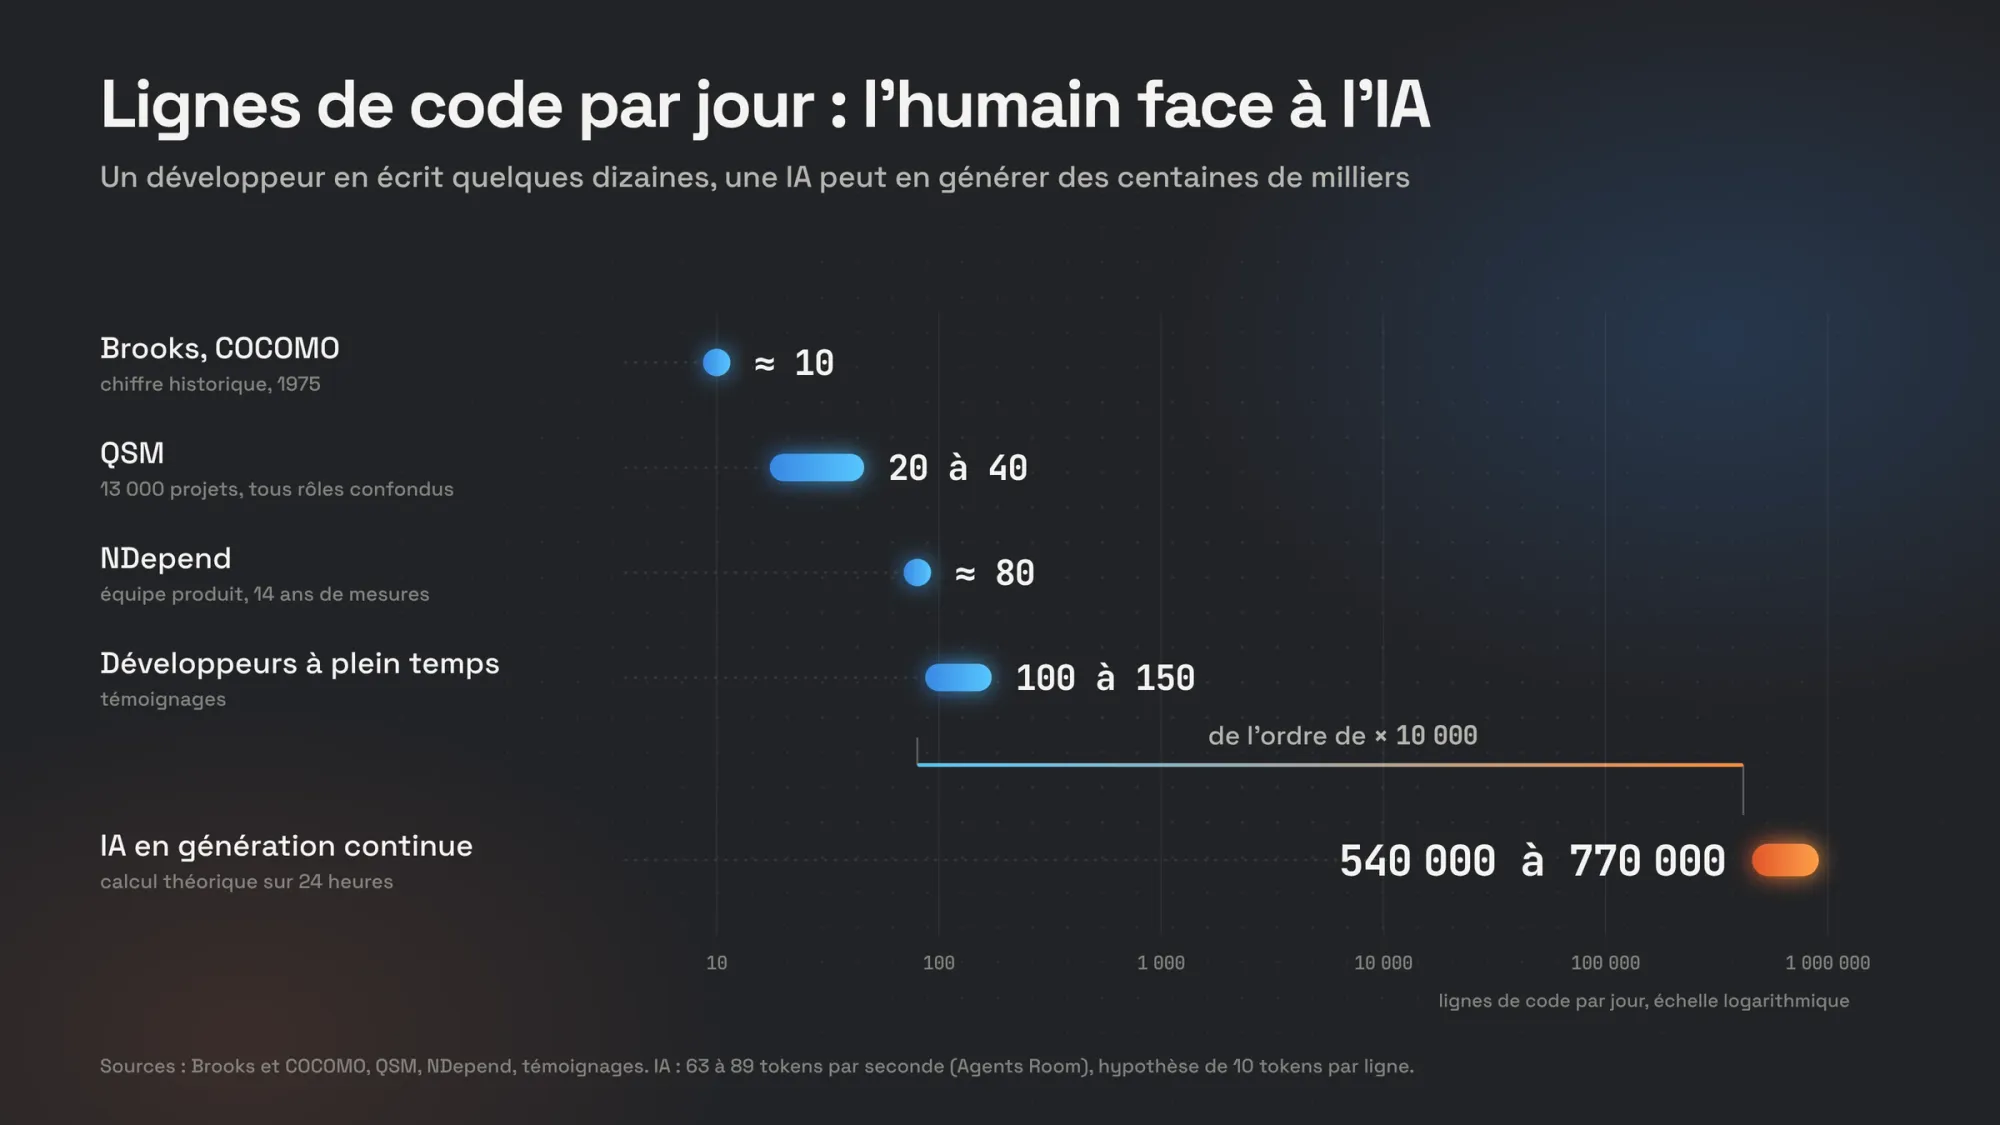
Un développeur écrit très peu de code : une dizaine de lignes par jour selon le chiffre attribué à Fred Brooks[2], de 20 à 40 d'après la base QSM, qui recense 13 000 projets (c'est ma conversion de ses chiffres mensuels, tous rôles confondus)[3], environ 80 pour une équipe produit suivie pendant quatorze ans[4]. Cela s'explique facilement : selon Microsoft, écrire du nouveau code n'occupe qu'environ 15 % de sa journée[5]. Le reste du temps est consacré à comprendre le besoin, à concevoir, à tester et à relire.
Une IA n'a pas ces limites. À la vitesse mesurée de Claude Code, soit 63 à 89 tokens par seconde[6], et en comptant une dizaine de tokens par ligne (c'est mon hypothèse), un seul agent génère en une heure ce qu'un développeur à 80 lignes par jour écrit en un an, et entre 540 000 et 770 000 lignes en une journée de génération continue.
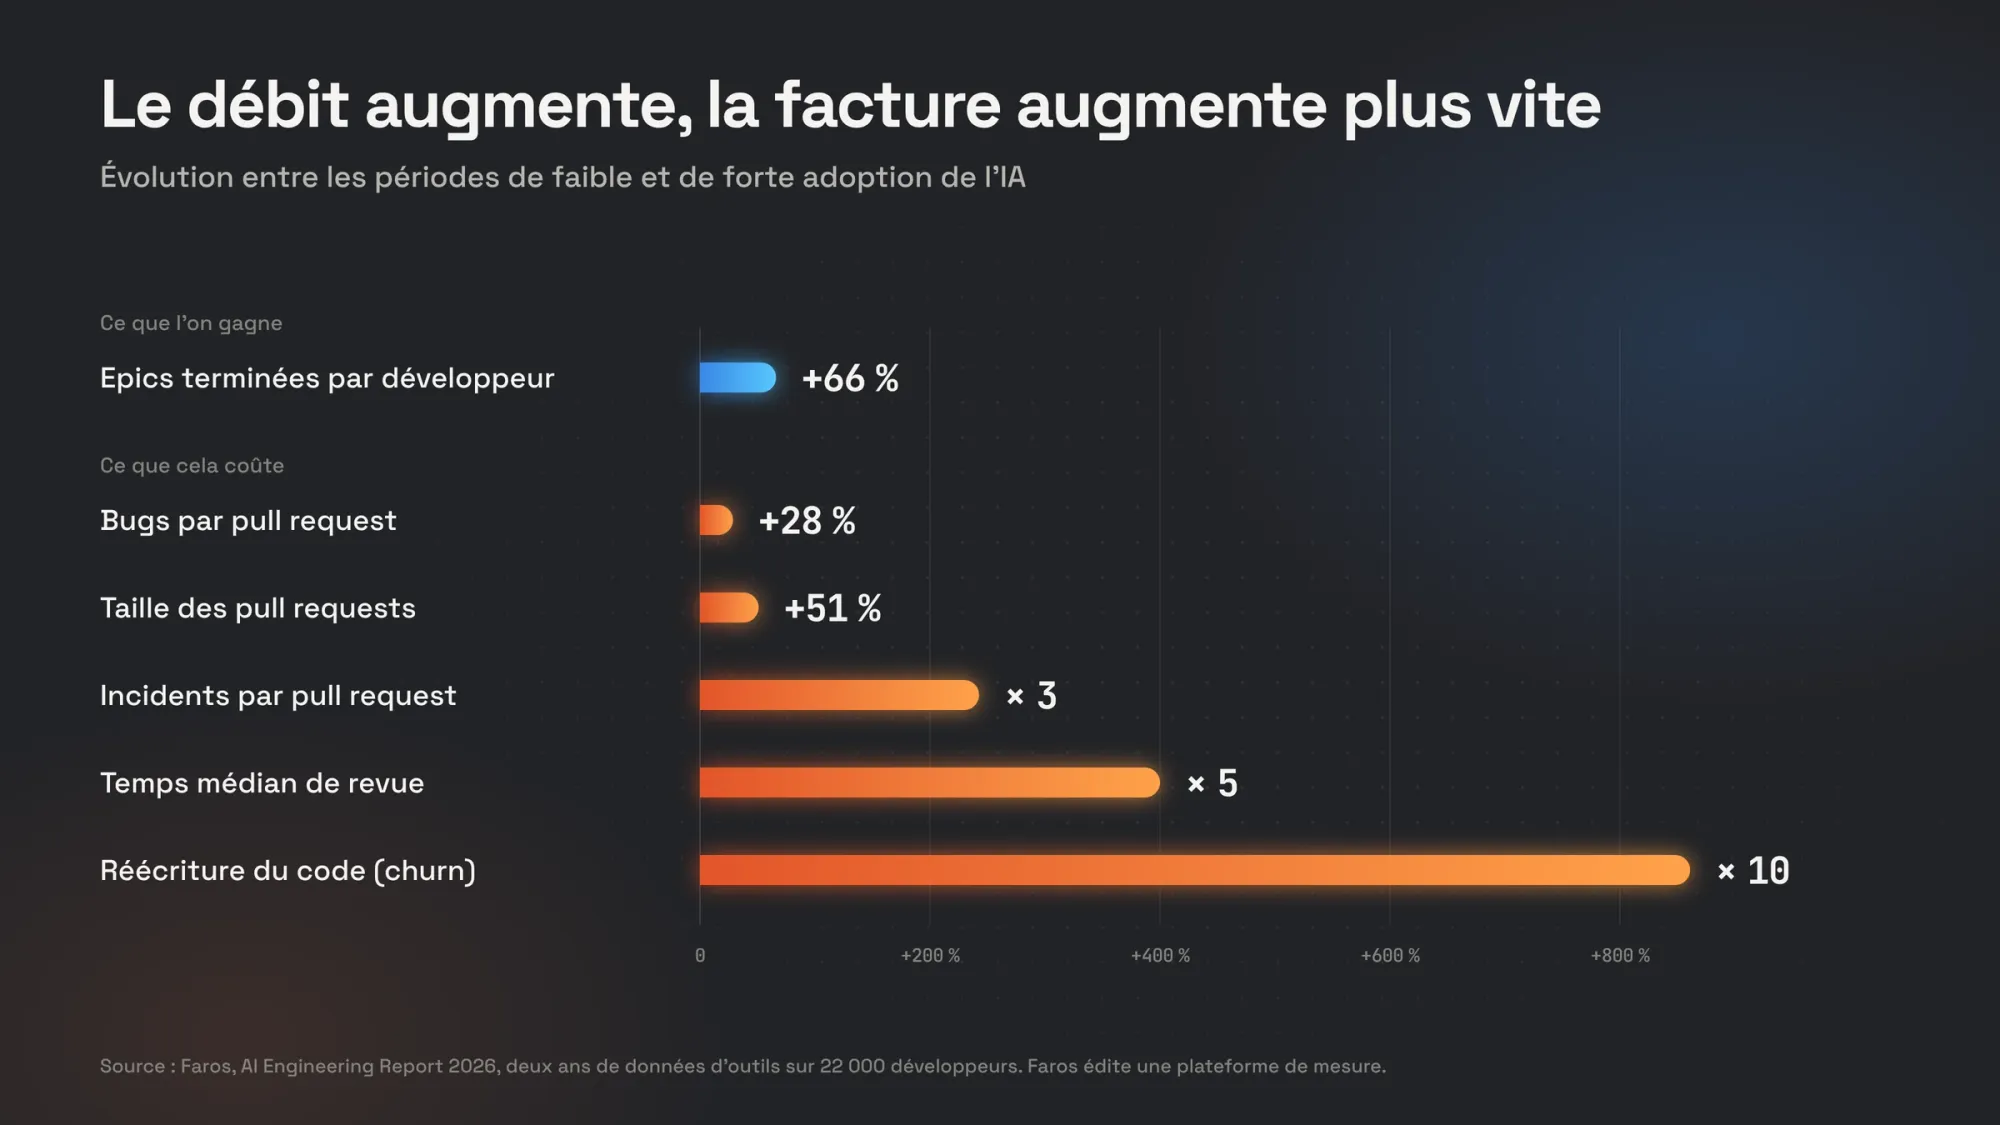
Si les lignes de code mesuraient la productivité, les gains seraient spectaculaires. Sur le terrain, c'est loin d'être le cas. DX, sur 121 000 développeurs, observe un gain d'environ 10 %, stable depuis les premiers mois, alors que l'IA écrit déjà 26,9 % du code en production[7]. Microsoft mesure 24 % de pull requests fusionnées en plus chez ses ingénieurs équipés d'agents[8]. Faros compte 66 % d'epics terminées en plus par développeur, mais la facture suit[9]. J'avais expliqué en 2025 comment mesurer les gains de productivité d'une équipe après le déploiement de GitHub Copilot et comment visualiser son impact avec Power BI : l'exercice s'est nettement compliqué depuis.
Deux précautions s'imposent devant ces chiffres. Ils viennent presque tous d'éditeurs qui vendent des outils de mesure ou des assistants de code. Et ils vieillissent vite : en 2025, l'institut METR montrait que des développeurs expérimentés mettaient 19 % de temps en plus avec l'IA[10]. En février 2026, il a déclaré son propre résultat dépassé, sans parvenir à le remesurer, car de 30 à 50 % des développeurs interrogés évitaient les tâches qu'ils ne voulaient plus faire sans IA[11]. C'est pour cette raison que je considère qu'une étude de plus d'un an sur le sujet n'est plus fiable.
Le volume n'a jamais été la bonne mesure
Deux lois, qui datent toutes deux de 1975, expliquent ce décalage.
La première est celle de Goodhart : lorsqu'une mesure devient une cible, elle cesse d'être une bonne mesure[12]. Si vous payez vos développeurs au nombre de lignes, vous obtiendrez du code verbeux. Si vous récompensez le nombre de tickets fermés, les tickets seront découpés en tâches minuscules. En 2023, McKinsey a proposé de mesurer les contributions individuelles des développeurs. Kent Beck et Gergely Orosz ont répondu que ce cadre comptait l'effort et le volume, pas les résultats[13]. Avec l'IA, le problème s'aggrave, car il suffit de quelques secondes pour gonfler une métrique de volume. Garry Tan n'a d'ailleurs pas triché, il a simplement compté ce que ses agents produisaient. DORA en a tiré la conséquence en 2026 : il faut cesser de se fier aux métriques de production[14].
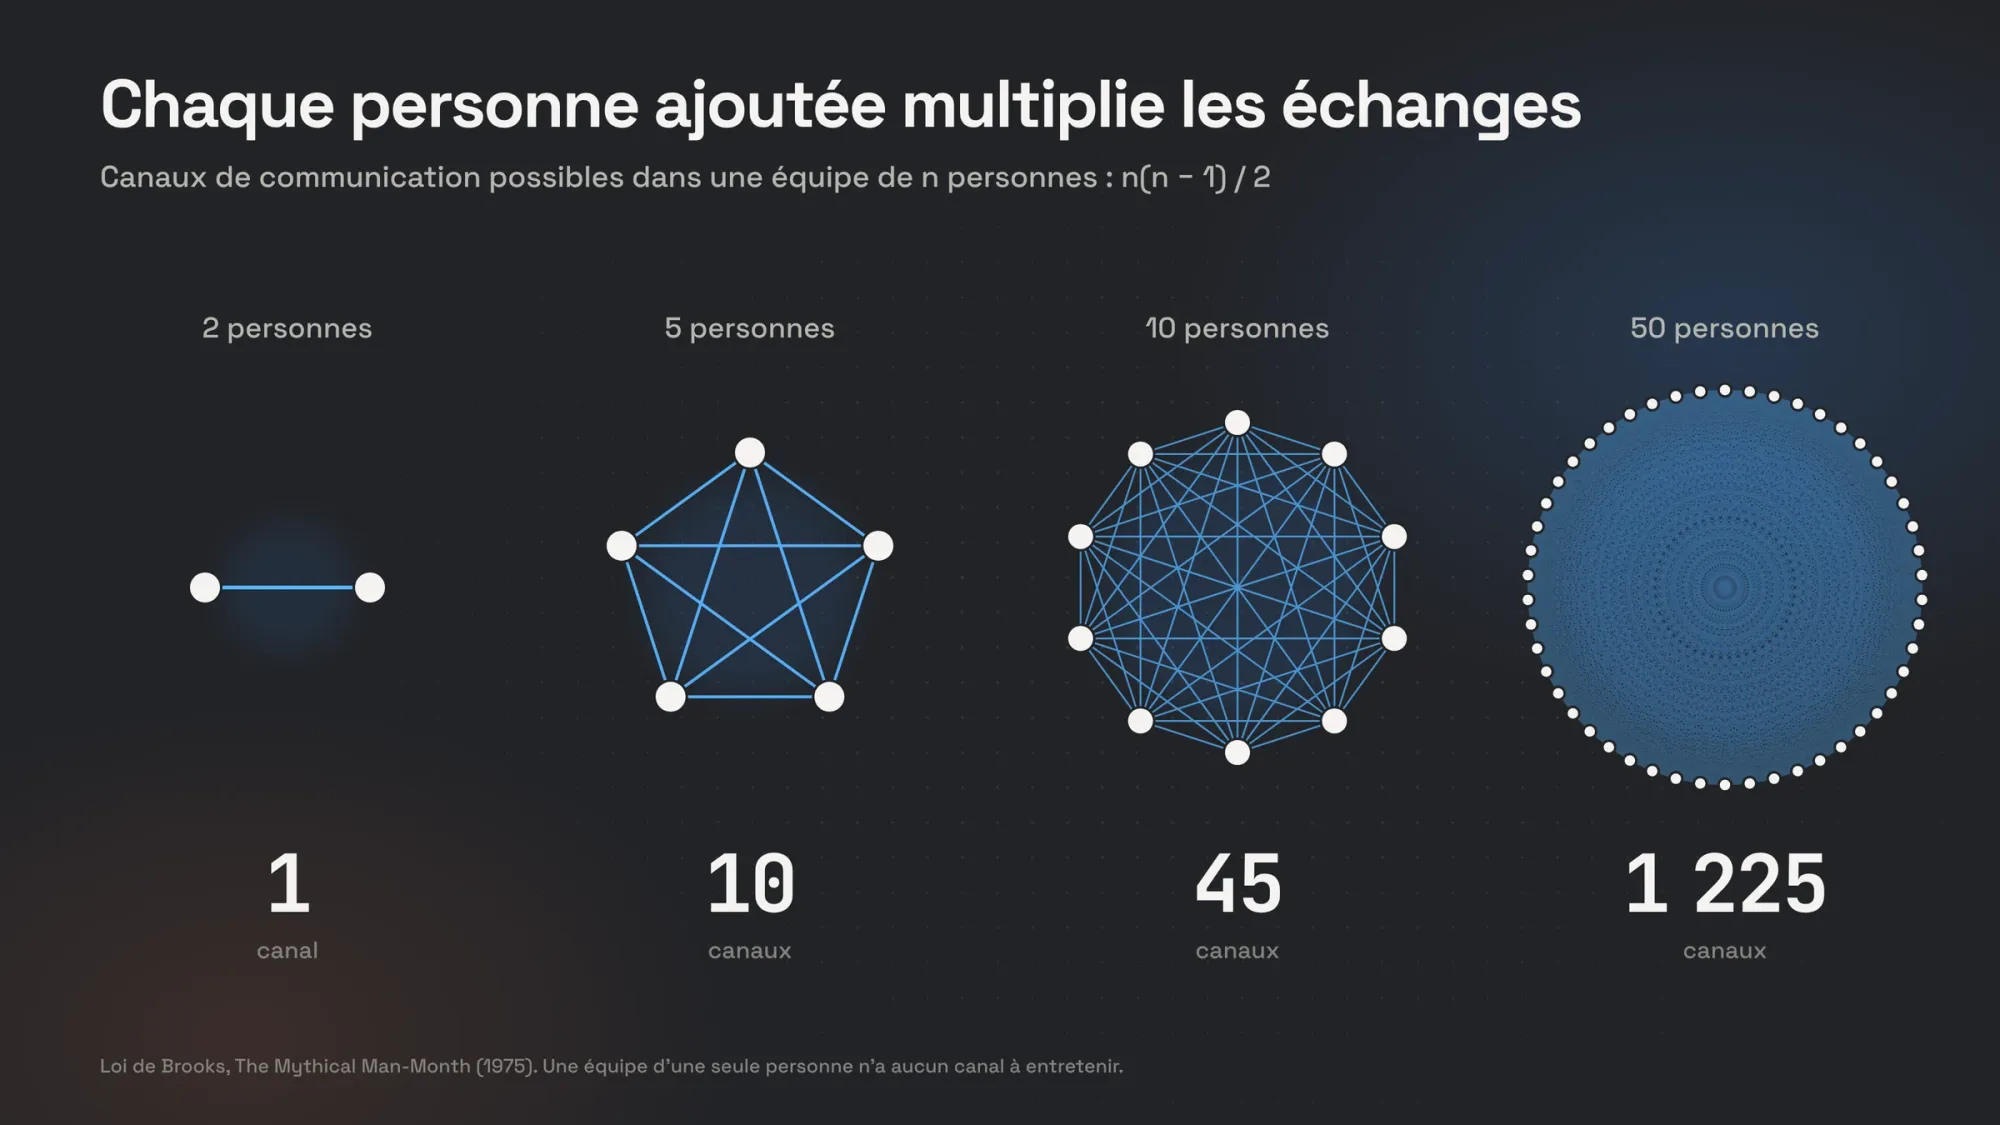
La seconde est celle de Brooks : le travail d'une équipe est d'abord de la coordination. Dans une équipe de n personnes, le nombre de canaux de communication possibles vaut n(n-1)/2[15], soit 45 pour dix personnes et 1 225 pour cinquante.
C'est aussi ce qui explique la vitesse du développeur seul qui prototype avec l'IA, comme pour cette application iPhone créée en vibe coding : il n'y a personne avec qui se coordonner, pas de code existant à respecter, et l'exigence de qualité est faible. Selon des travaux de Stanford repris par DORA, le gain atteint 35 à 40 % sur des tâches simples en terrain vierge, et tombe à 10 % ou moins sur du code ancien et complexe[16].
Le goulet s'est déplacé vers la relecture
Comme l'écriture du code n'était pas le goulet d'étranglement, l'accélérer ne fait que déplacer la file d'attente vers l'étape suivante. Faros mesure un temps médian de revue multiplié par cinq, avec des pull requests 51 % plus volumineuses et 28 % de bugs en plus par pull request[9:1]. LinearB constate que les pull requests issues de l'IA ne sont fusionnées dans les trente jours que dans 32,7 % des cas, contre 84,4 % pour le travail non assisté[17].
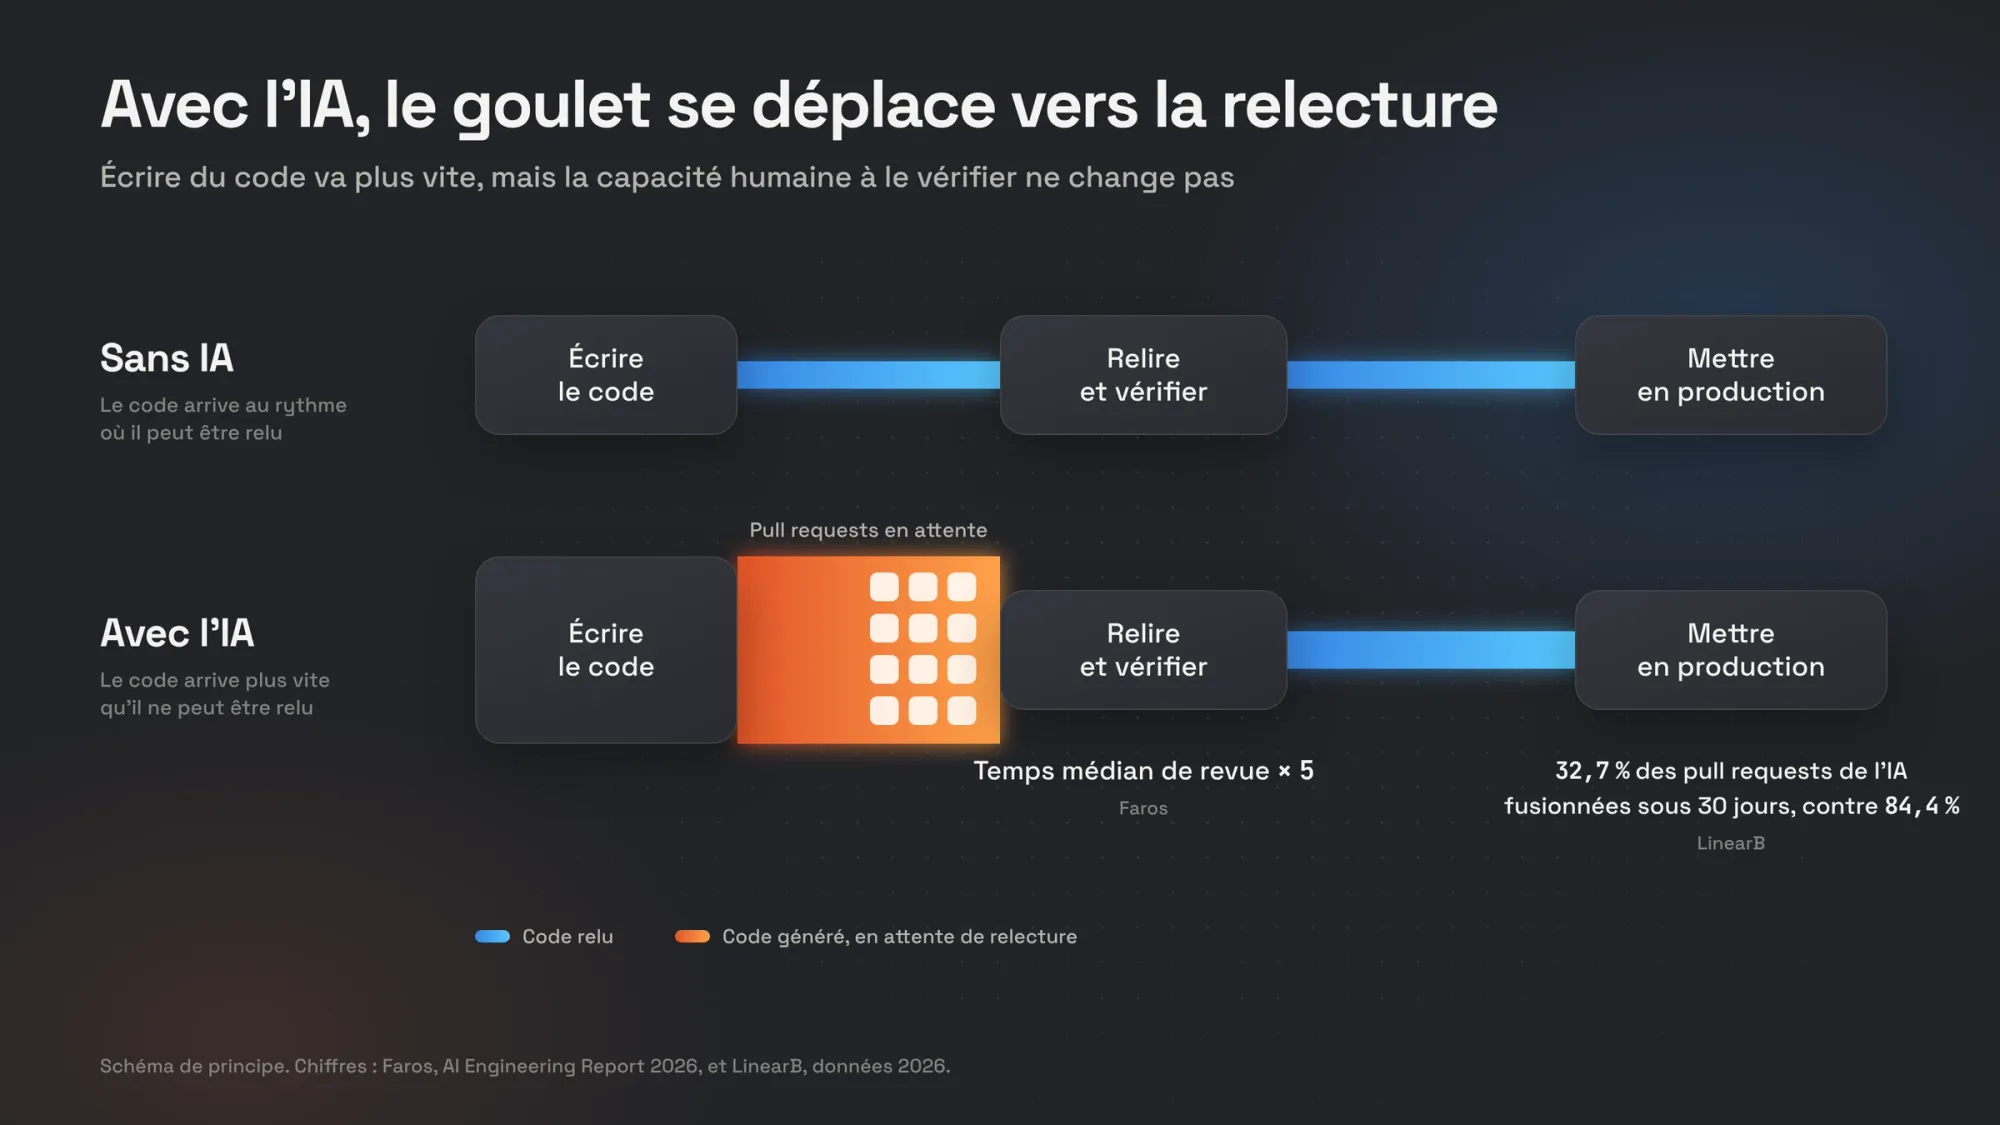
Lorsqu'un développeur pilote plusieurs agents en parallèle, c'est lui qui devient le facteur limitant, car il doit vérifier et assumer tout ce qui part en production.
Faut-il encore relire le code de l'IA ?
C'est, à mon sens, la question centrale. Si la relecture humaine ne suit plus, et si les meilleurs modèles écrivent un code plus propre que celui de bien des développeurs, pourquoi continuer ?
Ma conviction est simple : la revue humaine doit rester obligatoire, à proportion du risque engagé. Sur un projet personnel, pas de revue. Sur un système bancaire, où une erreur peut engendrer des millions d'euros de pertes, plusieurs revues humaines s'imposent.
La thèse inverse a pourtant ses défenseurs. En juin 2026, le chercheur Martin Monperrus a publié « The End of Code Review ». Selon lui, les agents remplissent tous les objectifs de la revue à moindre coût, et l'humain relecteur obligatoire n'offre qu'une assurance de façade, puisqu'il finit par approuver un code plausible sans vraiment le lire[18]. L'éditeur Semgrep défend une version plus pragmatique : une IA relit chaque changement, et seules les exceptions remontent à un humain[19].
Les mesures disponibles sont plus nuancées. Fin 2025, CodeRabbit comptait, sur 470 pull requests open source, 10,83 problèmes par pull request coécrite avec une IA, contre 6,45 pour celles écrites par des humains[20], sur des modèles déjà remplacés depuis. Côté relecture, un banc d'essai d'octobre 2026 montre que le meilleur agent, fondé sur Claude Opus 5, détecte 79,6 % des bugs que des humains avaient trouvés avant la fusion[21]. C'est un très bon score, mais il en manque encore un sur cinq.
À partir de quand la relecture ne sera-t-elle plus nécessaire ?
Personne ne peut donner de date aujourd'hui, mais les progrès sont rapides : sur ce même banc d'essai, le taux de détection est passé de 47,7 % à 71,9 % en cinq mois, entre Claude Opus 4.6 et Opus 5[21:1].
Je pense que la bascule se fera progressivement, par catégorie de risque. Selon Martin Monperrus, elle a déjà commencé pour les changements à faible enjeu : montées de version de dépendances, refactorisations, ajouts de tests[18:1]. Semgrep estime qu'à terme, moins de 1 % des pull requests devraient remonter à un humain[19:1]. Les dernières concernées seront probablement les modifications difficiles à corriger après coup, comme la sécurité, les migrations de données ou les choix d'architecture.
Pour s'en passer, il faudra surtout être capable de vérifier le code autrement qu'en le lisant, avec des tests qui prouvent le comportement, de l'analyse statique et un second modèle qui relit le premier.
Que se passe-t-il si l'on ne relit plus ?
Le goulet d'étranglement se déplace une nouvelle fois. Si écrire et relire le code ne coûtent presque plus rien, il reste à décider quoi construire et à vérifier que le résultat correspond bien au besoin. Savoir rédiger une bonne spécification devient alors la compétence la plus recherchée.
La relecture ne sert pas uniquement à trouver des défauts, elle permet aussi de diffuser la connaissance du code dans l'équipe. Une analyse de 3 100 prises de position de praticiens décrit ce que coûte sa disparition : une dette de compréhension, une perte d'appropriation du code et des relecteurs qui perdent la main[22]. Le risque est de se retrouver avec un système que plus personne dans l'équipe ne comprend.
Reste la responsabilité : en cas d'incident en production, c'est toujours une personne ou une équipe qui devra en répondre, pas l'IA.
Faut-il garder des compétences techniques, et comment apprendre sans produire ?
Oui, et je pense que ces compétences deviennent encore plus importantes. La chercheuse Lisanne Bainbridge l'a décrit dès 1983 dans « Ironies of Automation » : plus un système est automatisé, plus l'humain n'intervient que dans les situations que la machine ne sait pas traiter, donc les plus difficiles, alors même qu'il a perdu l'habitude de pratiquer. C'est pour cette raison que les pilotes de ligne continuent de s'entraîner en simulateur.
L'apprentissage est justement le point le plus fragile. Dans un essai randomisé publié par Anthropic en janvier 2026, 52 développeurs, pour la plupart juniors, devaient apprendre une bibliothèque inconnue. Ceux qui étaient assistés par l'IA ont obtenu un score de compréhension inférieur de 17 points, sauf lorsqu'ils s'en servaient pour poser des questions et demander des explications plutôt que pour tout déléguer[23]. L'IA n'empêche donc pas d'apprendre, à condition de ne pas tout lui déléguer.
Les seniors d'aujourd'hui ont appris en écrivant du code. Ceux de demain devront apprendre autrement : en lisant et en critiquant ce que la machine produit, en lui demandant d'expliquer plutôt que de faire, en apprenant à fournir le bon contexte, et en gardant des exercices sans assistance, comme un pilote garde des heures de vol manuel. Chez Microsoft, les ingénieurs les plus juniors essaient d'ailleurs moins les agents que leurs aînés[8:1]. Une organisation qui veut encore des experts dans dix ans doit protéger ce temps d'apprentissage, même s'il dégrade ses indicateurs à court terme.
Alors, que mesurer ?
- Mesurez l'équipe plutôt que l'individu. En France, la CNIL rappelle qu'un dispositif de contrôle de l'activité doit être proportionné, soumis à la consultation du CSE à partir de 50 salariés, et connu des personnes concernées[24].
- Suivez les résultats plutôt que le volume. Délai de mise en production, fréquence de déploiement, taux d'échec et temps de rétablissement.
- Mesurez la vérification. Temps de revue, taux de réécriture, incidents : c'est là que l'IA déplace le coût.
- Calculez le coût complet. Anthropic indique un coût moyen d'environ 13 dollars par développeur et par jour actif pour Claude Code en entreprise[25], et bien davantage si l'usage n'est pas maîtrisé. J'ai détaillé comment réduire sa consommation de tokens avec Claude Code et la facturation au token de GitHub Copilot.
- Évaluez la compréhension. Qui, dans l'équipe, sait encore expliquer ce que fait le système ? Aucun outil ne le mesure aujourd'hui, alors que cet indicateur deviendra probablement le plus important.
- Datez vos chiffres. Refaites vos mesures à chaque génération d'outils.
En synthèse
Mesurer la productivité des développeurs au volume de code n'a jamais bien fonctionné, et l'IA rend cette mesure inutilisable. Le sujet se déplace vers la vérification du code produit. Voici les trois points à retenir :
- mesurez les résultats de l'équipe, pas le nombre de lignes ou de pull requests ;
- automatisez la vérification (tests, analyse statique, relecture par un second modèle) et rendez la relecture humaine obligatoire à proportion du risque engagé ;
- protégez le temps d'apprentissage de vos développeurs, surtout celui des plus juniors.
Et vous, relisez-vous encore tout le code généré par vos agents ? Laissez un commentaire sous cet article et venez en discuter sur le Discord Geeek, ouvert à tous.
Fast Company, After Garry Tan touted his agentic coding output, a developer looked under the hood, et le résumé d'AI Weekly ↩︎
Skeptics Stack Exchange, Do professional software developers write an average of 10 lines of code per day? ↩︎
Developpez.com, Que vaut le mythe du mois-homme face à des statistiques de 14 ans de dev à temps plein ? ↩︎
Microsoft, arXiv, EngThrive: Make It Fast and Easy to Do Great Work ↩︎
Agents Room, How Fast Is Claude Code? Tokens per Second, Measured on 20,000 Turns ↩︎
ShiftMag, This CTO Says 93% of Developers Use AI, but Productivity Is Still 10% ↩︎
Microsoft, arXiv, Adoption and Impact of Command-Line AI Coding Agents: A Study of Microsoft's Early 2026 Rollout of Claude Code and GitHub Copilot CLI ↩︎ ↩︎
Faros, AI Engineering Report 2026: The Acceleration Whiplash ↩︎ ↩︎
METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity ↩︎
METR, We are Changing our Developer Productivity Experiment Design ↩︎
Wikipédia, Goodhart's law, pour l'énoncé de Charles Goodhart (1975) et la formulation de Marilyn Strathern (1997) ↩︎
Gergely Orosz et Kent Beck, The Pragmatic Engineer, Measuring developer productivity? A response to McKinsey, et LeadDev, What McKinsey got wrong about developer productivity ↩︎
DORA, Balancing AI tensions: Moving from AI adoption to effective SDLC use ↩︎
InfoQ, New DORA Report Claims Strong Engineering Foundations Drive AI Return on Investment ↩︎
LinearB, AI in software development: what the 2026 data shows ↩︎
Martin Monperrus, arXiv, The End of Code Review: Coding Agents Supersede Human Inspection ↩︎ ↩︎
Semgrep, The End Is Nigh for Code Review ↩︎ ↩︎
CodeRabbit, State of AI vs Human Code Generation Report ↩︎
arXiv, (When) Should a Software Factory be Lights-off? Benchmarking Code Review Agents on Bug Detection ↩︎ ↩︎
Anthropic, How AI assistance impacts the formation of coding skills ↩︎
Anthropic, documentation de Claude Code, Manage costs effectively ↩︎
En cours de traitement
Nous avons rencontré une erreur en envoyant l'email, réessayez à nouveau